DeepSeek 驱动的加密行情分析器:规则看见,模型裁决
每天早上十点,Telegram 会推给我一条两千字左右的简报;盘中想看细节,再问它 /detail。它不说“买”还是“卖”,只说三件事:手上这八个仓位接下来四个小时大概走在什么区间里,每个仓位现在有多危险,以及——为什么。
但真正决定“要不要认输”的不是这条简报。那是另一层:一组确定性规则先把“值得看一眼”的仓位挑出来,再让 DeepSeek 回答一个问题——这一仓开仓时的逻辑,是不是已经被破坏了。它输出 hold / trim / exit,附置信度、风险分和一句理由;至于要不要真的执行,还得过一道确定性门槛。
两层都是只读的。这篇文章讲这条链:规则怎么看见,模型怎么裁决,以及为什么最后一步必须由代码而不是模型来扣扳机。
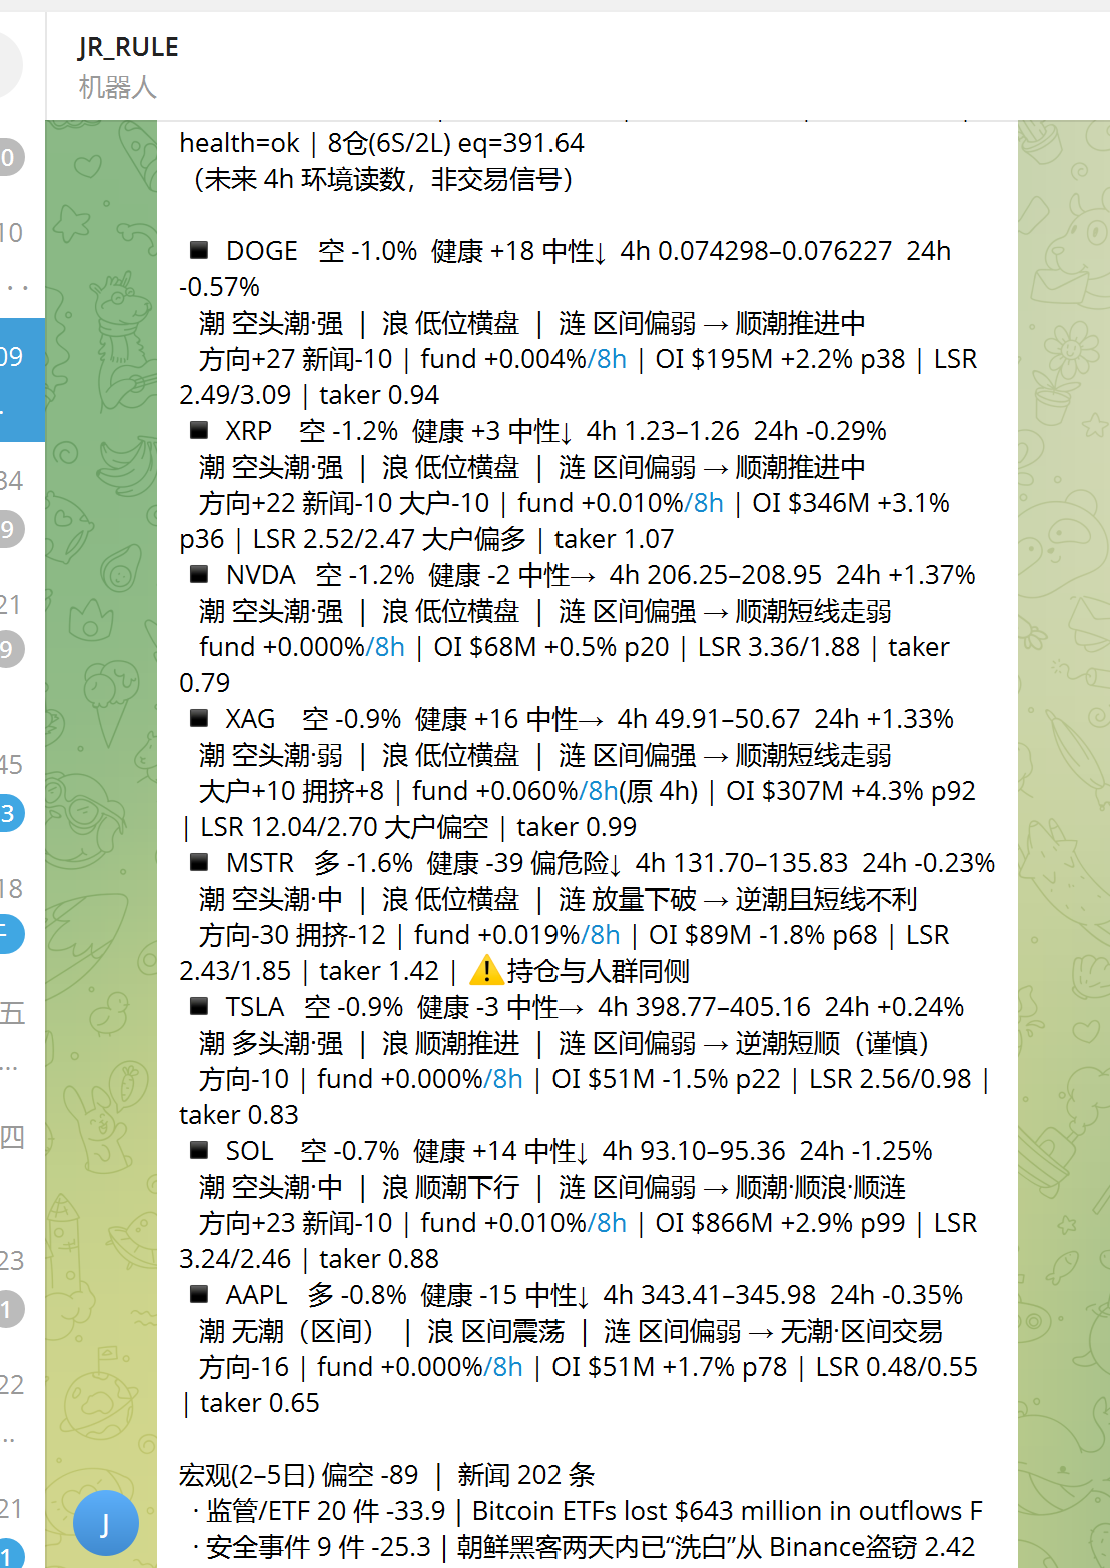
图 1|分析层每天 10:00 的多品种看板。标题行写着“未来 4h 环境读数,非交易信号”
一、四个角色,各管一段
| 角色 | 可以做什么 | 不可以做什么 |
|---|---|---|
| 确定性规则 | 采数、算区间、打分、挑候选、触发 −15% 硬止损 | 判断“开仓逻辑是否已被破坏” |
| DeepSeek(deepseek-chat) | 输出 hold / trim / exit、置信度、风险分、理由与失效条件 | 直接下单、改杠杆、改 DCA、改入场 |
| 策略(custom_exit) | 只读本地 SQLite,命中才执行全平或部分减仓 | 在策略进程里访问网络 |
| 操作员 | 启停、切 dry/live、调阈值、人工平仓 | 让 AI 无人值守接管资金 |
四条边界里最硬的是第二行:模型只能“建议”,执行权在策略和门槛手里。所以这套东西最坏的情况是“给你一个错的建议”,而不是“替你做了一个错的决定”。
这条边界不是为了保守,而是为了可归因。模型说错了,你能翻出它当时看到的数据、给出的理由和失效条件;如果它还能直接下单,这些记录就都变成了事后解释。
二、两层怎么接
1 | 币安 REST ─┐ |
一句话分工:分析层负责“把市场说清楚”,裁决层负责“这一仓还成不成立”。
前者可复算,同一个输入永远同一个输出;后者是定性的,同样的事实,不同的人可能给出不同结论。把两者混在一起,出错时你就永远分不清是数据错了还是判断错了。
三、模型看到什么
候选:先把绝大多数时刻排除掉
| 规则 | 条件 | 语义 |
|---|---|---|
| hard_stop | 浮亏 ≤ −15% | 直接平,不调用模型 |
| fast_loss | 持仓 ≥ 6h 且 ≤ −6% | 快速亏损 |
| age_loss | 持仓 ≥ 12h 且 ≤ −4% | 慢亏但没回本 |
| htf_counter | 持仓 ≥ 8h、逆 4h 趋势、≤ −0.5% | 方向错了,靠时间阴跌 |
| stale | 持仓 ≥ 24h 仍在亏 | 长期占用保证金 |
为什么不把所有仓位直接丢给模型?成本和信噪比。8 个仓位、每 60 秒扫一次,一天 11520 次判断,其中绝大多数是“没事”;模型的价值不在这些时候,而真正需要判断的时刻,一天可能只有一两次。
所以顺序是反的:规则先做减法,把候选压到个位数,模型只在候选上做加法。
上下文:一次给全,但不给它编造的机会
- 持仓侧:开仓价、当前价、杠杆、浮亏、持仓时长、DCA 层数、历史最大浮盈;
- 市场侧:4h / 1d 的 EMA 结构、RSI、ATR、资金费率、OI;
- 拥挤度:多空账户比、大户持仓比、主动买卖比、费率趋势、基差、24h 量能,5 个免费端点,15 分钟缓存,单个接口挂了只是缺字段;
- 组合层:同因子且同方向的保证金占比、整本净敞口、平均相关性。
组合层有个例外要单独处理:同板块反向腿是对冲,不该算成集中风险,所以只统计“同因子 + 同方向”。
Prompt 里写死三条规则:不准编造;必须区分事实与推断;必须给出“失效条件”。数据缺失就写“数据缺失”,宁可 hold + low,也不要为了“做点什么”而减仓。
“失效条件”那条值得单说:它不是给模型自己看的,是给 20 小时后的复盘看的。模型说“跌破 342 就说明这次判断错了”,复盘时就能直接检验这句话——判断从一句形容词变成了一个可验证的命题。
契约:严格 JSON,温度 0
1 | {"action":"hold|trim|exit","size_fraction":0.0,"confidence":"low|medium|high", |
校验是逐字段的、确定性的:action / confidence 只能是枚举值,risk_score 必须是 0–5 的整数(布尔值不算),trim 的 size_fraction 必须落在 (0, 0.9] 并吸附到预设档位,rationale 不能为空。任何一条不合规,直接记 llm_failed,不猜、不修、不重试到行为漂移。
temperature: 0,超时 15–20 秒。一个具体的坑:max_tokens 一开始设 256,中文理由经常在句子中间被截断,JSON 直接失效;调到 512 才稳定。
四、模型说 exit,不等于真的平仓
模型输出之后,还有一道 gate:
| 模型输出 | 旧行为 | 现在 |
|---|---|---|
exit + high + risk ≥ 4 |
全平 | 全平 |
exit + medium + risk ≥ 4 |
丢弃 | 降级为 50% 减仓 |
exit + medium + risk = 3 |
丢弃 | 丢弃 |
trim + medium/high + risk ≥ 3 |
减仓 | 减仓 |
第一版的门槛是二值的:exit + high + risk≥4 才全平,其余一律不动。上线后拉了 28 小时统计,exit+high 只出现 2 次,而 exit+medium+risk4 出现 42 次、全部被丢掉——其中一笔 XRP 多单就那样一路亏到 −6.6%。
这不是模型不准,是门槛的“分辨率”错了。把确信度当开关(信 / 不信),等于把 42 次中等确信的警告全扔了。改成分级之后,同样的输出变成“先减一半”,风险留在中间地带,既不装死,也不一刀切。
一次真实的裁决长这样:
1 | {"action":"exit","size_fraction":0.0,"confidence":"medium","risk_score":4, |
过 gate 时,medium + risk 4 不会全平,而是被改写成 action=trim, size_fraction=0.5,并写入一条 gate_note。策略看到的只是“减一半”,账本里留的却是“模型原本想全平、被门槛折中”——两条信息都得留着,否则事后分不清是模型太激进,还是门槛太保守。
状态机只有五个状态:
1 | pending ─┬─ hard_stop ──────────────→ exit_recommended |
策略侧只认三件事:status == exit_recommended、未过期、trade_id 匹配。退出原因写成 llm_exit_<signal_id> 或 watchdog_local_hard_stop,事后能追到是哪条判断、哪次调用。
还有两个不起眼但很值的工程细节:同一仓位 15 分钟内不重复送模型(去重),信号 45 分钟过期(防止拿旧判断做新决定)。
五、供数层为什么必须确定性
裁决层再聪明,也得有人先把事实摆对。分析层做的就是这件事,而且它一行 LLM 都没有——判断必须可复算,否则账本没有意义。
三周期投票:15m / 6h / 1d 各投五票,加权成 −1~+1 的方向分;4h 区间用 15m 历史上“恰好 4 小时”的窗口算 P10–P90。
这里最贵的坑是 RSI 和布林读反了:线性上涨的样本里 RSI 打到 100、价格贴着上轨,三个投票项同时给出“超买→看跌”,结果是系统性地做空每一次突破。修正只有一条:突破中顺势,震荡中才反向。
4h 区间还有个更隐蔽的坑:滚动窗口一旦跨过周末缺口,区间宽度会虚胖到 ±2.5%,等于什么都覆盖了。只保留时间严格连续(间隔正好 4h)的窗口后,XAG 收到 ±0.9%。卡片上那行「样本 2984(独立 = 186)」就是它的痕迹——2984 是 15m 的滚动窗口数,按 4h 视界折算,真正独立的只有 186 个:分位数看起来有三千个样本,其实只有一百八十几个。
新闻面:11 个源,金额 ≥ $100M 判重大。第一版 161 条里判出 60 条“重大”,基本是噪声——Rp114 Trillion 被当成 114 万亿美金、$19.5B net income 被当事件、$171B customer assets 盖住了标题里的 $5.8B outflow。修正后同一天只剩 19 条,最大 $6.3B。
衍生品:XAU / CL / XAG 是 4 小时结算,BTC / TSLA / AAPL 是 8 小时,不折算就会得出“黄金比比特币便宜”的反向结论(XAG 那次 0.0298%/4h 折出来是 0.0596%/8h、年化 65.3%,一看就知道是拥挤而不是便宜);全市场多空比是账户比,大户是持仓比,两者不能相减,只能各自比自己的 20 日分位。
健康度:六个分项可加,方向 ±35、区间 ±20、拥挤 ±25、大户 ±10、新闻 −25~0、浮盈 ±10,正向封顶压低、负向给重。同日同方向的持仓能差出 78 分(ADA −54 对 AVAX +25)——如果所有仓位分数都差不多,这个模型就没有存在价值。
这套东西的价值不在“猜得准”,而在“说得清”:任何一个分数都能拆回分项,任何一个分项都能拆回原始数据。
六、三重滤网:把数字换成一句人话
1d = 潮、6h = 浪、15m = 涟,三层组合映射成一句结论,无量突破一律降级为“存疑”。简报因此从 2975 字符压到 2119 字符——不删信息,只删数值。
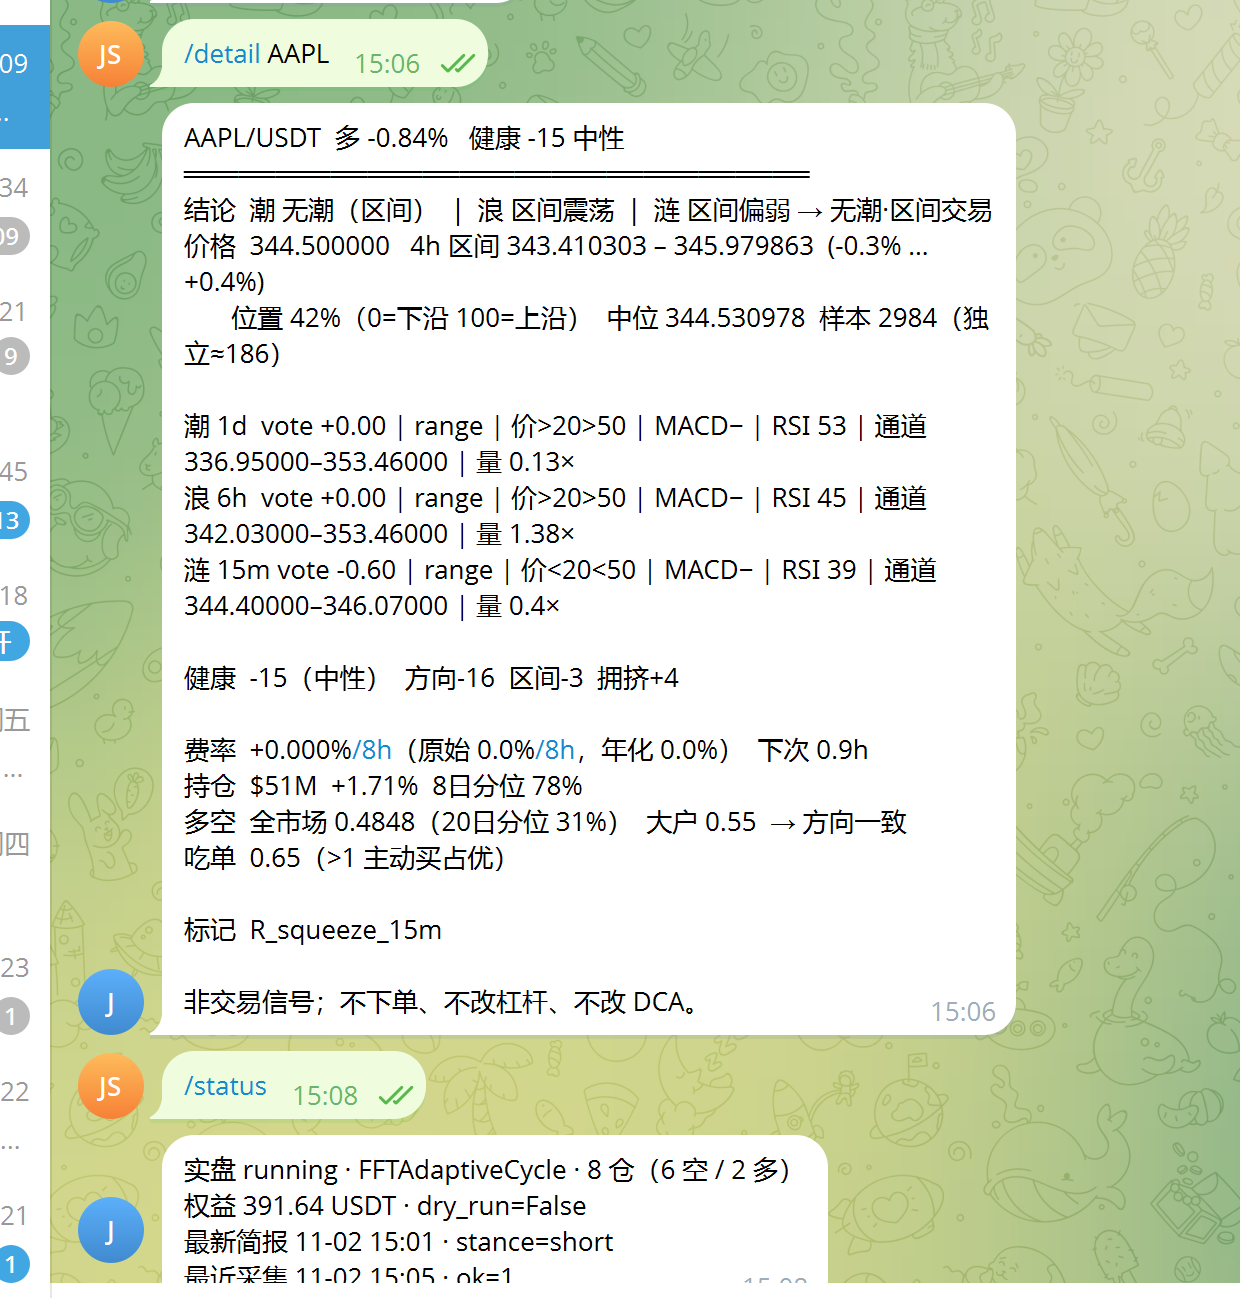
图 2|
/detail AAPL的完整卡,下半截是/status
拿这张卡读一遍:结论行 潮 无潮(区间) | 浪 区间震荡 | 涟 区间偏弱 → 无潮·区间交易,三层独立判定,1d 和 6h 的 vote 刚好相互抵消在 +0.00,15m 的 −0.60 是全卡最明确的一项。
健康分 −15(中性)方向 −16 区间 −3 拥挤 +4 可以手算:价格 344.50,4h 区间 343.41–345.98,位置 42%,对多单而言贴边程度 1 − 0.42 = 0.576,代入 (0.5 − 0.576) × 40 得 −3——和中位差的那一点,就是这 −3 分。
吃单 0.65(>1 主动买占优) 括号里是口径说明不是结论,0.65 意味着主动卖占优;R_squeeze_15m 是标记不是结论,波动压缩本身不告诉你往哪边开。整张卡最后一句是给自己看的:非交易信号;不下单、不改杠杆、不改 DCA。
下半截的 /status 是另一条线索:running · FFTAdaptiveCycle · 8 仓 · 权益 391.64 USDT · dry_run=False。策略在跑,分析层在旁路看着它——两者之间只有一条 127.0.0.1 的只读 REST,没有别的耦合。
七、账本:模型也要被记账
判断不能被证伪,就只是噪声的另一种写法。所以两层都有自己的账本。
分析层四张表:scores 记 4h 方向命中,band_scores 记区间覆盖(期望 80%),reviews 记逐仓 4h / 24h 走势与“对持仓有利度”,macro_scores 记 2–5 日宏观判断。
裁决层记的是另一样东西:每条信号保存 snapshot、prompt、模型原始输出、状态、gate 备注和时间。模型说错了,你能翻出它当时看到的是哪几根 K 线、哪一档费率、哪个组合敞口。
一个反直觉的数据点:早期版本上线 8 小时,signals 表 0 条、LLM 调用 0 次。不是程序没跑,是当时的候选规则要求价格偏离 EMA20 达到 2%,而那一夜 BTC/ETH 浮亏扩大到 −20% 以上,价格相对 EMA20 最大只偏离 **−0.88%**——缓跌 + EMA 跟随,规则永远等不到。
“模型一次都没被叫”本身就是一个结论:不是模型没用,是候选规则没覆盖到这种行情。后来候选改成了以浮亏、时长、逆势为主的组合,才有了可用的样本。
八、工程约束
部署在一台 Ubuntu 上,本机只写代码跑单测。原因很实际:本机到币安和英文 RSS 超时,服务器到中文站 403 / 404,只有 ChainCatcher 两边都通。
依赖只有标准库:urllib 而不是 requests,xml.etree 自己解 RSS 和 Atom,数据库用内置 sqlite3。代价是超时、重试、退避要自己写;好处是部署就是 tar 加解包,没有依赖漂移。
调度是“一个心跳”而不是“一排定时器”:mi-tick.timer 每小时 :05 唤醒,decide() 决定跑 daily 还是 hourly,job_state 记“今天跑没跑”,停机错过只补一次。sentinel 是独立进程,60 秒轮询一次,挂了也不影响 bot。
九、边界与风险
- 模型看不到的东西:链上数据、期权偏斜、新闻原文。Prompt 要求“缺失就说缺失”,不会编造,但这也意味着它的结论有盲区;
- 股票类标的:AAPL / TSLA 在闭市时段取不到完整的 5m K 线;
- 阈值仍是先验:所有分数只看相对排序,别看绝对值;
n ≥ 20之前不给调参建议; - gate 不是保险:它只把“高确信”放行,不保证放行的一定对;
- 执行层也会坑你:有一次
adjust_trade_position返回-current_amount * current_rate,在 Freqtrade 2025.10 的负 stake 语义下换算出的数量超过持仓,日志里刷了 21,841 条Remaining amount of -...,减仓全部被拒。AI 判对了,也不代表能执行——这条链路上一共有三个可能出错的地方:数据、判断、执行。
结语
这套系统的分工可以用一句话说完:规则负责看见,模型负责裁决,账本负责证伪。
规则把市场说清楚、把候选压到个位数,让每次模型调用都值得看;模型只回答“逻辑还在不在”,并且必须给出置信度、风险分和失效条件;最后一道门槛决定这份建议是变成一个动作,还是只留一条记录。
它不预测行情。它做的是三件更朴素的事:把判断摊开(可归因)、把判断写死(可复算)、把判断记下来(可证伪)。如果三个月后账本证明 4h 方向确实没有增量、或者 DeepSeek 的裁决并不比“一律持有”更好,那就把它降级成“只展示”——那也是一个结论。
 wechat
 alipay